Jev voor SEO en GEO: slimme techniek met een veel te groot verhaal
Ik heb Jev de afgelopen week zeker 2.000 keer voorbij zien komen op social media.
Dat getal heb ik niet wetenschappelijk vastgesteld. Na drie dagen voelde het al als 2.000 en toen ben ik opgehouden met tellen.
De boodschap was overal ongeveer dezelfde. Jev zou beslissingen honderd keer sneller nemen dan een gewoon taalmodel en voor een paar cent kon je duizenden zoektermen beoordelen, complete websites doorlichten, interne links bepalen en meten welke bedrijven ChatGPT noemt.
En dan begint het bij mij te jeuken.
Als een nieuw AI-model binnen een paar dagen overal opduikt met tientallen toepassingen, honderden rekensommen en opvallend weinig resultaten uit echte SEO-projecten, wil ik eerst weten hoeveel werk er naast dat model blijft liggen. Dus heb ik de documentatie gelezen, het artikel waar de meeste posts naar verwijzen en de eerste onafhankelijke tests.
Er bleef nogal wat werk liggen.
Wat doet Jev precies?
Jev is een beslismodel van TypeSafe AI, op 15 september 2026 uitgebracht als early access. Je geeft het informatie, je stelt een afgebakende vraag en je geeft de antwoorden op waaruit het mag kiezen. Artikelen schrijven of uitgebreide analyses maken hoort er niet bij.
Een paar voorbeelden van zulke vragen:
- Is deze zoekterm commercieel, informatief of waardeloos?
- Past pagina A inhoudelijk bij pagina B?
- Wordt dit merk aanbevolen in het antwoord?
- Welke concurrent uit deze lijst wordt genoemd?
- Scoort deze pagina laag, gemiddeld of hoog op een vaste meetlat?
Naast het antwoord krijg je een waarschijnlijkheid terug, de confidence. Je software beslist daarna of het antwoord wordt overgenomen, naar een mens gaat of wordt weggegooid.
TypeSafe noemt een antwoordtijd van 70 tot 500 milliseconden en zegt dat Jev daarmee 40 tot 200 keer sneller is dan de grote taalmodellen. De prijs is 0,042 dollar per miljoen tokens invoer en de uitvoer is gratis. Dat is zo goedkoop dat het in een begroting nauwelijks nog opvalt.
Het idee is bruikbaar, vooral als je tienduizenden bijna gelijke beslissingen moet nemen.
In de eigen documentatie schrijft TypeSafe dat Jev het best werkt als elke vraag één specifiek en goed afgebakend ding vraagt. Weegt een beoordeling meerdere factoren, dan moet je hem opknippen in losse vragen en de uitkomsten zelf in code combineren.
Daar begint het minder aantrekkelijke deel van het verhaal, want dat opknippen en combineren is gewoon werk.
Een goedkope beslissing maakt nog geen SEO-product
Stel dat Jev voor minder dan een euro duizenden AI-antwoorden kan indelen. Dan heb je nog altijd geen GEO-audit.
Eerst moet je bepalen welke vragen echte klanten stellen. Daarna haal je de antwoorden op bij verschillende AI-systemen en leg je vast vanuit welk land je meet, in welke taal, of webzoeken aanstaat en op welk moment. Wij doen dat met dertig tot vijftig vragen die we zes keer stellen, verspreid over vier dagen, omdat één antwoord statistisch weinig zegt.
Dan moet iemand controleren of een merk echt wordt aanbevolen. Een naam in een rijtje van acht is iets anders dan een aanbeveling en een bronlink naar de site van een klant is iets anders dan een artikel waarin de naam toevallig voorkomt.
En als een concurrent vaker verschijnt, moet iemand uitzoeken waarom. Ligt het aan de inhoud van zijn website, aan publicaties op andere sites, aan betere productinformatie of aan één bron die veel AI-systemen gebruiken?
Jev kiest uit de antwoorden die jij vooraf hebt bedacht en geeft daar geen onderbouwing bij.
De goedkoopste stap uit het proces wordt dus nog goedkoper. De uren voor onderzoek, interpretatie, uitvoering en controle blijven gewoon op de factuur staan.
De SEO- en GEO-voorbeelden zijn vooral voorbeelden
Het artikel dat ik het vaakst gedeeld zag, komt van Ryze AI en verscheen op 20 september. Het beschrijft negen toepassingen voor advertenties, SEO en GEO, van zoektermen beoordelen en interne links voorstellen tot kannibalisatie herkennen, dunne pagina’s tegenhouden en AI-vermeldingen meten.
Het klinkt indrukwekkend. In hetzelfde artikel staat alleen ook dat de getoonde runs gesimuleerd zijn en dat de cijfers op het scherm ter illustratie dienen. De kosten zijn uitgerekend met de prijslijst van TypeSafe en dus niet gemeten. En Ryze gebruikt Jev zelf nog niet in productie, omdat er op dit moment alleen een wachtlijst is.
Dat is een behoorlijk belangrijk detail. Ergens tussen de eerste screenshot en de twintigste enthousiaste samenvatting is het een beetje zoekgeraakt, net als het feit dat de meeste ondernemers die er nu over lezen het model nog niet eens kunnen gebruiken.
Jev kwam op 15 september uit. Een week later stonden er complete strategieën, verdienmodellen en omzetprognoses online. Een model kan snel zijn, alleen heeft een praktijkcase wat meer tijd nodig.
Wat zeggen de onafhankelijke tests tot nu toe?
De eerste openbare tests geven een gemengd beeld en ze zijn nog klein, met honderd tot tweeduizend voorbeelden per test.
In een test met 200 klantvragen, verdeeld over 150 verschillende bedoelingen, zat Jev 87 procent van de keren goed. Een groot model van OpenAI haalde in dezelfde test 91,5 procent. Op een tweede set bankvragen kwam Jev op 83 procent. De onderzoeker noemde de uitkomst zelf onbeslist, omdat geen van beide tests de vooraf gestelde doelen haalde.
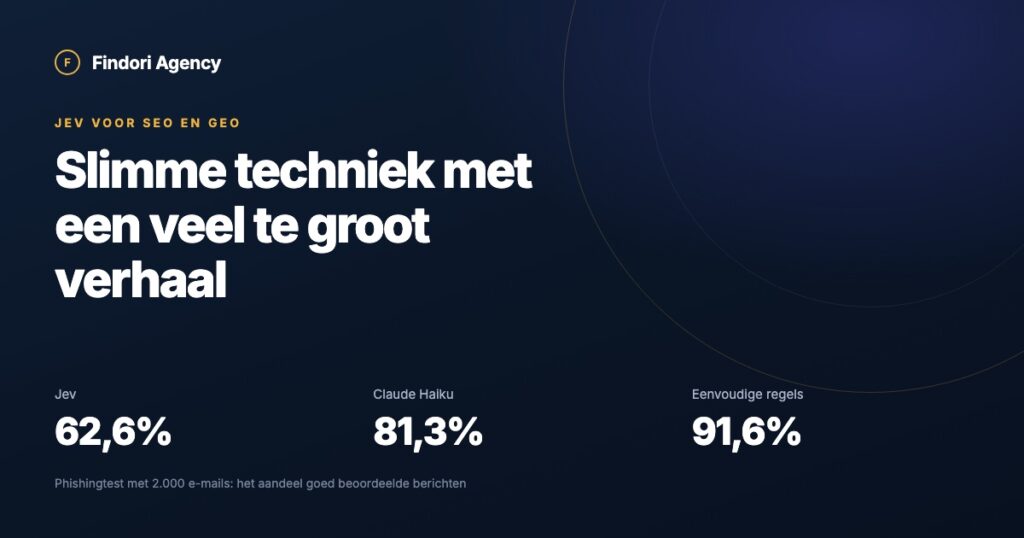
In een phishingtest met 2.000 e-mails haalde Jev 62,6 procent. Claude Haiku kwam op 81,3 procent. En een eenvoudige set regels die alleen naar links en domeinen keek, haalde 91,6 procent en versloeg daarmee allebei de modellen.
Het interessante zit in het vervolg van die test. Toen de onderzoeker de vraag opknipte in vijf kleine deelvragen en de antwoorden met een eenvoudige rekenregel combineerde, kwam Jev op 95,1 procent. Dat is precies wat TypeSafe in de documentatie adviseert. Het maakt ook zichtbaar waar het werk zit: in het bedenken van die vijf vragen en het bouwen van de rekenregel.
Een derde test kwam uit op 91 procent voor het indelen van nieuwsberichten en 87 procent voor bankvragen. Bij het herkennen van emoties bleef Jev steken op 48 procent en bij 16 procent van die voorbeelden gaf het model het juiste antwoord een kans van nul.
Duidelijke categorieën gaan vaak goed. Subjectieve oordelen en vragen met veel context gaan een stuk minder goed.
Wat zegt die confidence dan?
Het verkoopverhaal leunt zwaar op de confidence. Jev handelt de zekere gevallen af en voor een mens blijven alleen de lastige over.
In de praktijk werkt dat deels. Bij het indelen van nieuws en bankvragen kon Jev bij een foutmarge van 5 procent ruim 80 procent van de gevallen zelf afhandelen. Bij emoties bleef daar vrijwel niets van over.
In de test met de 150 bedoelingen gaf Jev bij 102 van de 200 vragen een confidence van 100 procent. Een model dat bij de helft van de vragen volledig zeker is, geeft je weinig houvast om de twijfelgevallen eruit te halen. Bij een iets strengere eis aan de nauwkeurigheid verdween het voordeel van Jev dan ook.
En elke drempel heeft een prijs. Hoe hoger je hem zet, hoe beter de geaccepteerde antwoorden worden en hoe meer werk er alsnog bij een mens of een groter model belandt. De prijs per beslissing blijft laag en de productie eromheen groeit vrolijk door.
Wat heeft een kleinere website hieraan?
Voor een website met 25, 50 of 100 pagina’s zie ik op dit moment weinig voordeel. Zo’n site heeft zelden twintigduizend zoektermen die elke nacht opnieuw beoordeeld moeten worden en er liggen ook geen miljoenen paginaparen te wachten op een interne link.
De eigenaar heeft meer aan antwoorden op vragen als deze:
- Welke diensten zoeken potentiële klanten precies?
- Welke pagina ontbreekt nog?
- Welke bestaande pagina verdient als eerste aandacht?
- Welke vragen beantwoorden concurrenten beter?
- Welke concrete ervaring, bron of onderbouwing ontbreekt?
- Begrijpt Google wie het bedrijf helpt en waarmee?
- Wordt het bedrijf genoemd in relevante AI-antwoorden en via welke bronnen komt dat?
Dat zijn vragen die onderzoek en uitleg nodig hebben. Je wilt kunnen terugzien waarom een aanbeveling er staat. En je wilt voorkomen dat een model met 94 procent confidence heel overtuigd de verkeerde afslag neemt, want dat brengen computers verrassend professioneel.
Bij een kleinere site levert een specialist die vijftig pagina’s echt bekijkt meestal meer op dan een systeem dat ze voor een fractie van een cent allemaal een cijfer geeft.
Wanneer wordt Jev wel interessant?
Jev krijgt een duidelijke functie zodra het volume groot genoeg is en dezelfde beslissingen steeds terugkomen. Denk aan een webwinkel met honderdduizenden producten, een uitgever met duizenden artikelen, een groot advertentieaccount met tienduizenden zoektermen of een platform dat elke dag berichten en aanvragen moet indelen.
Ook dan horen er voorwaarden bij. De categorieën moeten helder zijn en er moet een testset liggen waarvan je het goede antwoord al kent. Twijfelgevallen hebben een veilige route nodig en belangrijke wijzigingen gaan langs een mens.
In zo’n omgeving kan Jev een snelle eerste beoordelaar zijn. Het model sorteert de stapel en mensen pakken de gevallen op die aandacht verdienen.
Voor de gemiddelde zakelijke website is die stapel gewoon te klein. Je bespaart centen op het model en steekt ondertussen dagen in koppelingen, testsets, drempels en controle. Dat is een bijzondere manier van goedkoop uit zijn.
Wat goede SEO en GEO nog steeds vragen
Goede SEO begint bij begrijpen wat klanten zoeken en waarom ze uiteindelijk contact opnemen. GEO voegt daar één vraag aan toe: welke bronnen gebruiken AI-systemen als ze een antwoord samenstellen?
Daarvoor heb je heldere dienstpagina’s nodig, concrete ervaring, feiten die iemand kan controleren, techniek die zoekmachines kunnen lezen en andere sites die bevestigen dat je bedrijf bestaat en ergens verstand van heeft. Hoe dat er in de praktijk uitziet, lees je in GEO in de praktijk: wat werkt er echt?
Een beslismodel kan onderdelen van dat onderzoek ordenen. De inhoud, de ervaring en de autoriteit moet je nog altijd zelf opbouwen. Daar hebben kleinere bedrijven meestal ook het meeste te winnen.
Mijn conclusie over Jev
Ik schrijf Jev zeker niet af. De techniek is interessant en de eerste tests laten zien dat snel indelen in vaste categorieën echt kan werken, zeker als je de vraag in kleine stukken knipt.
Voor SEO en GEO van kleinere websites zie ik voorlopig weinig reden om er uren in te steken. De besparing zit op een plek waar nauwelijks kosten zitten. Het meeste werk blijft afhangen van goede vragen, betrouwbare data, iemand die meekijkt en de uitvoering op de website.
Dus staat Jev bij Findori voorlopig op de parkeerplaats. We kijken opnieuw als er echte SEO-cases liggen met resultaten die zich laten herhalen.
Dat scheelt weer een experiment dat vooral heel goedkoop verkeerde antwoorden had kunnen opleveren.
Bronnen
- TypeSafe AI: introductie van Jev (15 september 2026)
- TypeSafe AI: documentatie over afgebakende vragen
- Ryze AI: Jev voor advertenties, SEO en GEO (20 september 2026)
- Onafhankelijke test op Banking77 en CLINC150
- Phishingtest met 2.000 e-mails
- Test op nieuws, bankvragen en emoties met confidence-analyse
Klaar om gevonden te worden in Google en AI?
Vraag je AI-zichtbaarheidsaudit aan en zie zwart op wit waar je staat, en wie in jouw markt wel genoemd wordt.
Vraag je audit aanBenieuwd waar jij nu staat in Google en AI?
We doen een nulmeting over ChatGPT, Perplexity, Gemini, Copilot en Google AI Overviews, en sturen je een helder rapport met een plan voor de eerste negentig dagen.
Vraag je audit aan