We maken AI-zichtbaarheid meetbaar
Het Findori Visibility Framework laat zien hoe zichtbaar jouw organisatie werkelijk is in antwoorden van OpenAI, Gemini, Claude en Perplexity. Niet op basis van één toevallige vraag, maar met een vaste en controleerbare meting over meerdere modellen, vragen en meetdagen.
AI-zichtbaarheid meten lijkt eenvoudiger dan het is
Eén goede uitkomst zegt nog niet dat je zichtbaar bent
Vraag ChatGPT één keer naar jouw markt en misschien wordt je bedrijf genoemd. Stel dezelfde vraag morgen opnieuw en het antwoord kan anders zijn.
Dat maakt een losse prompt interessant, maar nog geen betrouwbare meting.
Veel AI-zichtbaarheidstools tellen alleen hoe vaak een naam voorkomt. Ze vertellen niet of het bedrijf echt wordt aanbevolen, hoe prominent het in het antwoord staat of welke bronnen het model gebruikt.
Daar hadden wij niet genoeg aan.
Als we klanten adviseren waar ze hun tijd en geld moeten investeren, willen we kunnen uitleggen waarop dat advies is gebaseerd. Daarom hebben we onze eigen meetstandaard ontwikkeld.
Geen onderbuikgevoel. Geen geheim algoritme. Gewoon aantoonbaar bewijs.
AI-zichtbaarheid is een nieuw vakgebied. Er bestaan nog geen universele posities zoals plek één, twee en drie in Google.
Toch worden er overal scores uitgedeeld.
Het probleem is dat je bij veel van die scores niet kunt zien hoe ze tot stand zijn gekomen. Welke vragen zijn gesteld? Hoe vaak is er gemeten? Welke modellen zijn gebruikt? Wanneer telt iets als een aanbeveling? En hoeveel invloed heeft een toevallig antwoord op het eindresultaat?
Wij vonden dat een klant daar recht op heeft.
Het Findori Visibility Framework is daarom gebouwd rond één uitgangspunt:
Iedere score moet uit te leggen en terug te voeren zijn op het oorspronkelijke bewijs.
Je kunt zien welke vraag is gesteld, welk AI-model antwoordde, of jouw merk werd genoemd, hoe het werd gepresenteerd en welke bronnen zijn gebruikt.
Dat maakt de uitkomst niet alleen meetbaar, maar ook bruikbaar.
Van een vaag onderwerp naar een bestuurbaar resultaat
Het Findori Visibility Framework is onze onderscheidende methode voor het meten van AI-zichtbaarheid. Het combineert vier dingen die meestal los van elkaar worden bekeken.
- zichtbaarheid over meerdere AI-modellen
- verschillende momenten in het aankoopproces
- meerdere metingen verspreid over verschillende dagen
- menselijke controle waar automatische regels onvoldoende zekerheid geven
Daardoor meten we niet alleen of jouw naam ergens voorkomt. We onderzoeken welke positie je merk binnen het antwoord krijgt en waar je zichtbaarheid verliest.
Dat verschil is belangrijk. Want genoemd worden is prettig. Aanbevolen worden is commercieel veel interessanter.
We meten niet alleen óf je zichtbaar bent, maar hoe
De Findori AI Visibility Score bestaat uit vier afzonderlijke onderdelen. Ieder onderdeel heeft een vaste en openbare weging.
Vermelding
Wordt jouw organisatie genoemd in een relevant AI-antwoord?
Dit is de basis. Als iemand vraagt naar aanbieders, oplossingen of experts in jouw markt, moet je naam überhaupt in beeld komen.
We meten dit over de volledige reeks vragen en modellen. Zo zien we of je structureel wordt herkend of alleen bij een paar toevallige vragen verschijnt.
Aanbeveling
Wordt jouw organisatie alleen genoemd of daadwerkelijk als passende keuze aanbevolen?
Een merknaam in een lange lijst heeft minder waarde dan een duidelijke aanbeveling met een reden waarom die organisatie geschikt is.
Daarom maken we onderscheid tussen voorkomen en gekozen worden.
Prominentie
Hoe zichtbaar staat jouw organisatie in het antwoord?
Een merk dat als eerste en uitgebreid wordt besproken, heeft een andere positie dan een merk dat onderaan kort wordt genoemd.
We kijken daarom naar de plaats, nadruk en context van de vermelding.
Eigen bronvermelding
Gebruikt het AI-model jouw eigen website als bron?
Een verwijzing naar je eigen domein laat zien dat jouw website niet alleen vindbaar is, maar ook daadwerkelijk als informatiebron wordt gebruikt.
Dat is belangrijk omdat je daarmee meer invloed krijgt op de feiten, uitleg en argumenten die in het antwoord terechtkomen.
Je hoeft ons niet op ons woord te geloven
We veranderen de weging niet per klant en voegen geen verborgen oordeel toe om de uitkomst mooier te maken.
Ook Share of Voice wordt apart gehouden. Daarmee vergelijken we jouw merk met vooraf vastgelegde concurrenten, maar die concurrentiepositie verandert de hoofdscore niet stiekem.
Zo blijft duidelijk wat we meten en waarom jouw score stijgt of daalt.
Niet één slimme prompt, maar 384 vergelijkbare waarnemingen
Voor een officiële AI-zichtbaarheidsaudit gebruiken we een vaste meetopzet.
24 onderzoeksvragen
We stellen 24 vragen die passen bij jouw markt en het aankoopproces van je klant. Die vragen verdelen we over zes intenties:
- ontdekking
- probleem en behoefte
- vergelijking
- aankoop
- autoriteit en vertrouwen
- brononderzoek
Zo meten we niet alleen of iemand jouw naam al kent, maar juist ook of je verschijnt wanneer een potentiële klant nog moet kiezen.
Vier AI-modellen
We meten de antwoorden van:
- OpenAI
- Gemini
- Claude
- Perplexity
Geen enkel model gebruikt precies dezelfde bronnen of formuleert ieder antwoord op dezelfde manier. Door meerdere modellen te gebruiken, voorkomen we dat één systeem het volledige beeld bepaalt.
Vier afzonderlijke meetdagen
AI-antwoorden kunnen per moment verschillen. Daarom spreiden we de audit over vier afzonderlijke dagen.
Menselijke controle
Automatische regels kunnen veel classificeren, maar taal is niet altijd zwart-wit.
Wanneer niet duidelijk genoeg is of een antwoord echt een aanbeveling bevat of hoe prominent een merk wordt gepresenteerd, gaat het antwoord naar menselijke review. We laten twijfel dus niet stilletjes verdwijnen in een algoritme.
Een veel steviger uitgangspunt dan één reeks screenshots op één middag.
Meten is niet genoeg. Je moet kunnen verklaren wat er gebeurt.
Het onderscheid zit niet in één losse formule. Het zit in de combinatie van vaste meetvoorwaarden, verschillende AI-modellen, commerciële vraagintenties, menselijke beoordeling en volledig bewijs.
Transparant
Iedere score is terug te voeren op vragen, antwoorden, bronnen en beoordelingsregels.
Herhaalbaar
We kunnen dezelfde meetopzet later opnieuw uitvoeren. Daardoor zie je niet alleen waar je staat, maar ook of je uitgangspositie werkelijk verandert.
Commercieel relevant
We meten vragen die aansluiten op ontdekking, vergelijking en aankoop. Niet alleen technische zichtbaarheid, maar de momenten waarop een potentiële klant een keuze voorbereidt.
Vergelijkbaar
Jouw zichtbaarheid wordt in dezelfde antwoorden vergeleken met relevante concurrenten.
Onafhankelijk van één model
De uitkomst wordt niet bepaald door één AI-platform of één gunstige prompt.
Gericht op actie
Het rapport eindigt niet bij een score. Iedere belangrijke bevinding wordt vertaald naar een prioriteit, quick wins en een plan voor de eerste negentig dagen.
Niet iedere meting hoeft een volledige audit te zijn
Voor een eerste indicatie kunnen we een beperkte snapshot uitvoeren. Een snapshot laat zien of er aanleiding is om verder te onderzoeken. Het is geschikt om snel een signaal op te halen, maar krijgt geen officiële Findori AI Visibility Score. Een echte audit gaat verder.
| Snapshot | Volledige audit |
|---|---|
| Beperkte reeks vragen | 24 vastgezette onderzoeksvragen |
| Eén beperkt meetmoment | Vier afzonderlijke meetdagen |
| Eerste indicatie | 384 vergelijkbare waarnemingen |
| Geen officiële score | Volledige AI Visibility Score |
| Signaleert kansen | Onderbouwt beslissingen |
| Beknopt resultaat | Adviesrapport en 90-dagenplan |
Snapshots signaleren. Audits bewijzen.
Geen dashboard waar je zelf conclusies uit moet trekken
- hoe vaak jouw organisatie wordt genoemd
- hoe vaak je daadwerkelijk wordt aanbevolen
- hoe prominent je in antwoorden verschijnt
- hoe vaak je eigen website als bron wordt gebruikt
- welke verschillen er tussen AI-modellen bestaan
- bij welke klantvragen je zichtbaar bent
- waar concurrenten vaker worden geselecteerd
- welke inhoud en bewijzen al goed werken
- waar je de meeste zichtbaarheid verliest
- welke verbeteringen als eerste aandacht verdienen
Je ontvangt niet alleen de conclusies. De volledige meetresultaten worden als bewijsbijlage opgenomen, zodat je kunt controleren waarop het advies is gebaseerd.
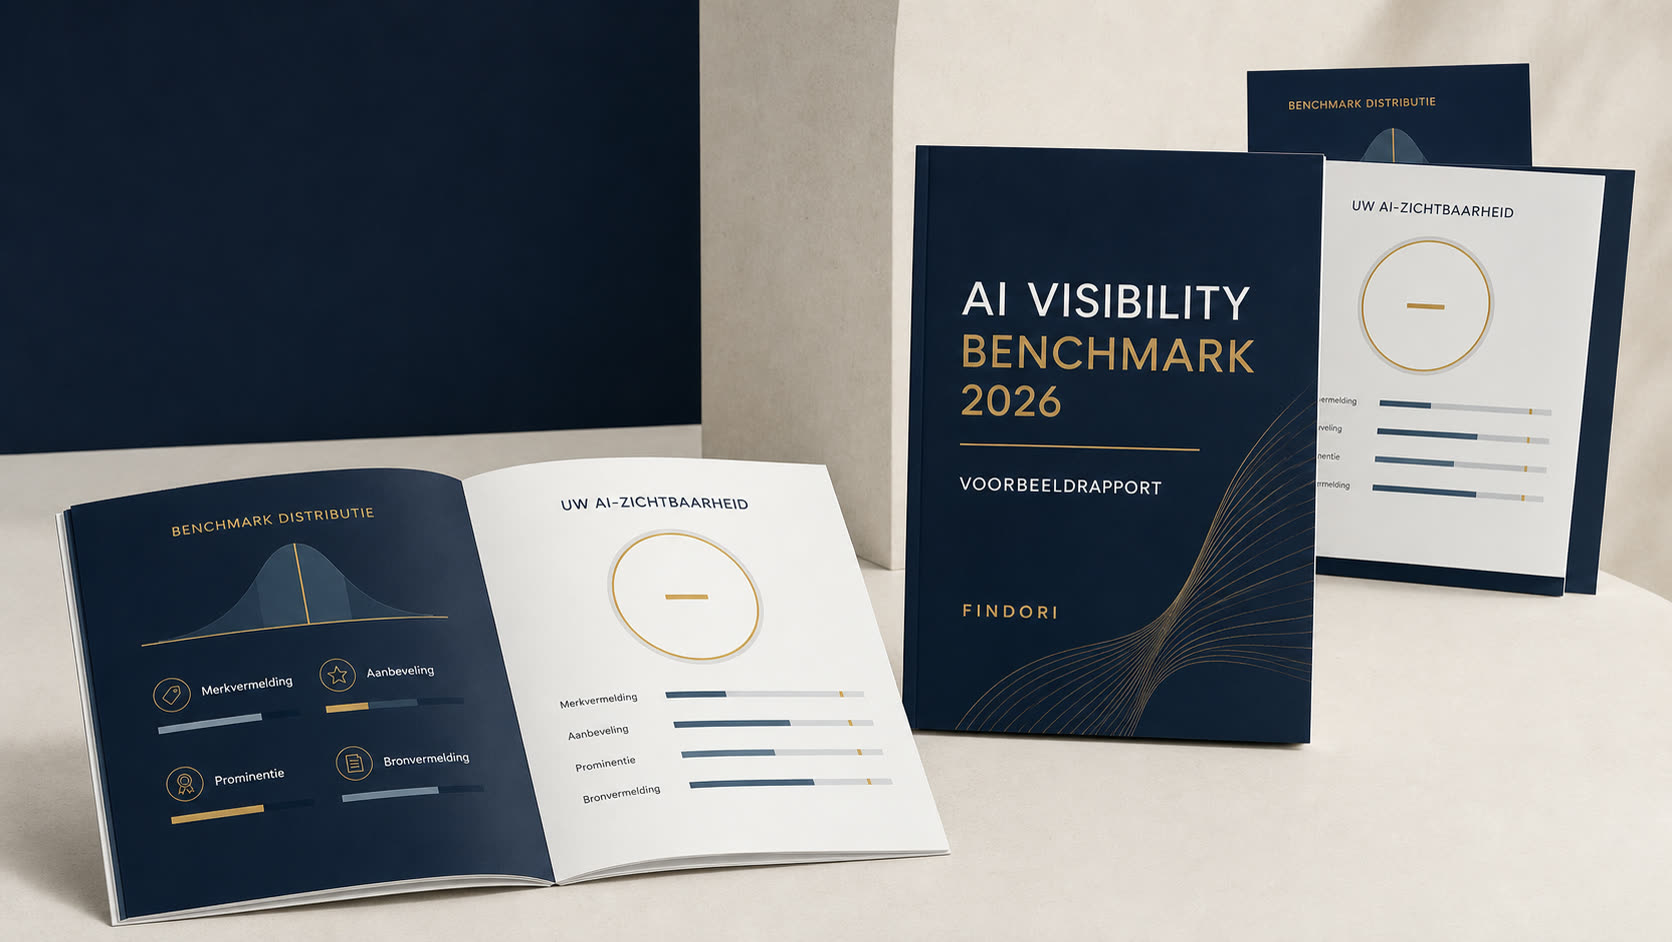 Voorbeeld van een AI Visibility Benchmark-rapport
Een score is het begin, niet het eindpunt
Een AI Visibility Score is alleen waardevol wanneer je weet wat je ermee moet doen. Daarom combineren we het framework met onderzoek naar je website, content, techniek, structuur en online autoriteit.
We brengen niet alleen in kaart dát je minder zichtbaar bent dan een concurrent. We onderzoeken waarom dat gebeurt en welke verbeteringen waarschijnlijk het meeste verschil maken. Na uitvoering meten we opnieuw onder dezelfde voorwaarden.
Zo ontstaat geen verzameling losse GEO-activiteiten, maar een duidelijke cyclus. Dat is hoe AI-zichtbaarheid bestuurbaar wordt.
Wil je de rekenkant zelf nalopen, dan staat die in de Academy: het framework stap voor stap en hoe je een bandbreedte leest.
Bij een maandtraject blijft die cyclus daarna vanzelf doorlopen. Wat er dan elke nacht gecontroleerd wordt en wanneer je bericht krijgt, staat op de pagina over de wachters.
Weet je niet of AI jouw bedrijf al ziet?
Met de Findori AI-zichtbaarheidsaudit zie je zwart op wit hoe jouw organisatie wordt genoemd, hoe je positie zich verhoudt tot concurrenten en waar de grootste kansen liggen.
Wat je waarschijnlijk wilt weten
Kunnen jullie garanderen dat AI mijn bedrijf aanbeveelt?+
Nee. Niemand kan bepalen welk bedrijf een AI-model in ieder antwoord noemt. We kunnen wel meten hoe je huidige positie eruitziet en gericht werken aan de signalen waarop AI-antwoorden worden gebaseerd.
Is de score iedere dag precies hetzelfde?+
Nee. AI-antwoorden kunnen veranderen. Daarom baseren we een officiële audit niet op één moment, maar op meerdere modellen, vragen en meetdagen.
Meten jullie alleen ChatGPT?+
Nee. We testen OpenAI, Gemini, Claude en Perplexity. Zo wordt de uitkomst niet afhankelijk van één AI-model.
Waarom gebruiken jullie menselijke review?+
Een aanbeveling is niet altijd met één woord te herkennen. Menselijke review voorkomt dat onduidelijke formuleringen automatisch als positief of negatief worden meegerekend.
Is de AI Visibility Score hetzelfde als verkeer of omzet?+
Nee. De score meet je zichtbaarheid en positie binnen de vastgezette onderzoeksvragen. Websitebezoek, aanvragen en omzet zijn andere resultaten en worden afzonderlijk gemeten.
Kan ik de score later opnieuw laten meten?+
Ja. Dat is juist een belangrijk onderdeel van het framework. Door dezelfde meetopzet opnieuw te gebruiken, kunnen we veranderingen onder vergelijkbare voorwaarden beoordelen.
Waarom krijgt een gratis check geen officiële score?+
Een beperkte check bevat onvoldoende meetmomenten voor een betrouwbare totaalscore. Hij is bedoeld om kansen te signaleren, niet om een volledige audit te vervangen.